视频拆解 · 2h01m · 2025 年 2 月录制

Karpathy 两小时:一个 zip 文件,和它全部的插头

这不是一场讲 agent、harness、loops、graphs 的课。这是一份极其具体的使用手册:先把模型讲成一个「1TB 有损 zip 文件」,然后挨个装上搜索、深度研究、文件、代码执行、artifacts、Cursor、语音、图像、记忆——每一步都告诉你它在哪里会骗你。

演讲者 Andrej Karpathy 转载 @0xkichiro 时长 2:01:25 点赞 473 浏览 69,677 推文日期 2026-11-17

一句话

模型本体是个封闭的 zip 文件:没有计算器、没有浏览器、没有 Python、没有任何工具,你和它之间只有 token。所以过去两年所有的产品进步,几乎全是在这个文件外面接插头——thinking / search / deep research / 文件上传 / 代码执行 / artifacts / Cursor / 原生语音 / 图像输入。他的整场方法就是一句话:先想清楚这个插头解决的是「知识过时」还是「不能算」还是「不能动手」,再判断它这次是不是在编。

那张总图

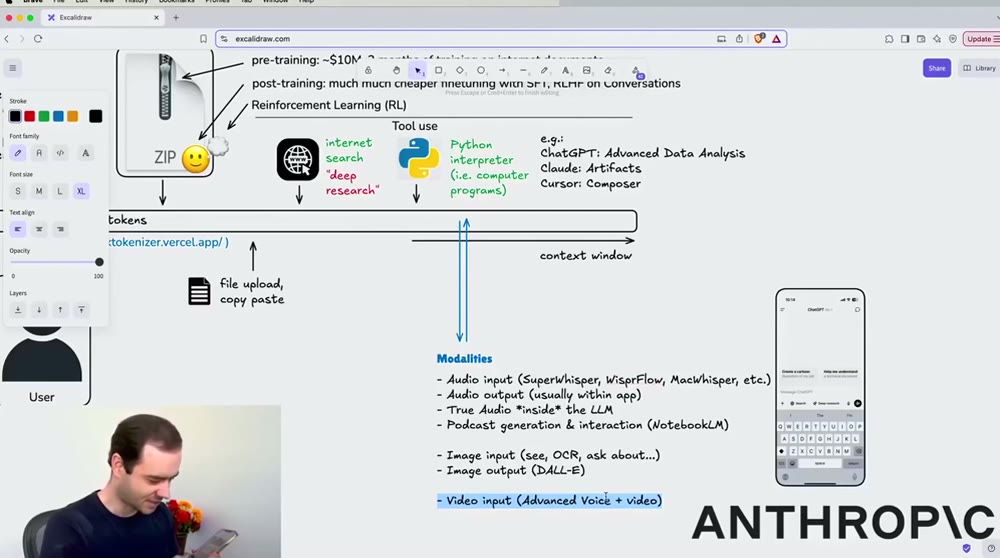
他整场只画了这一张图,边讲边往上加东西。到最后它长这样:左边是用户往 token 流里写字,中间是 zip 文件(预训练给知识、后训练给人格、RL 给思考),右边三支插头——联网搜索/深度研究、Python 解释器、以及「工具」这一整类(ChatGPT 的 Advanced Data Analysis、Claude 的 Artifacts、Cursor 的 Composer);下方是 file upload 与多模态。

Karpathy 的白板总图
01:41:30 · 白板上完整的一张图:zip 文件 + pre-training ~$10M / 3 months + post-training + Reinforcement Learning,右侧三支插头标注了 ChatGPT: Advanced Data Analysis、Claude: Artifacts、Cursor: Composer,下方列着 Modalities——音频输入(Superwhisper、WisprFlow、MacWhisper)、True Audio inside the LLM、podcast generation(NotebookLM)、图像输入(see / OCR / ask about)、图像输出(DALL·E)、视频输入(Advanced Voice + video)

他一层层加的东西

01 · 底座

zip 文件:1TB 参数 ≈ 互联网的有损压缩

预训练把整个互联网切 token、压进约 1 万亿参数(≈1TB);后训练再给它贴上「助手」的人格。结果是一个完全自足的实体——你把 token 流进去,它还你 token。它的知识有 cutoff、有概率、有强弱记忆。

"You're talking to a zip file. If you stream tokens to it, it will respond with tokens back."00:04:52

他还给这个实体写了一段自我介绍,是全场最好用的心智模型:

「Hi, I am ChatGPT. I am a 1 terabyte zip file. My knowledge comes from the internet, which I read in its entirety about six months ago, and I only remember vaguely. My winning personality was programmed by example, by human labelers at OpenAI.」00:05:16(白板原话)
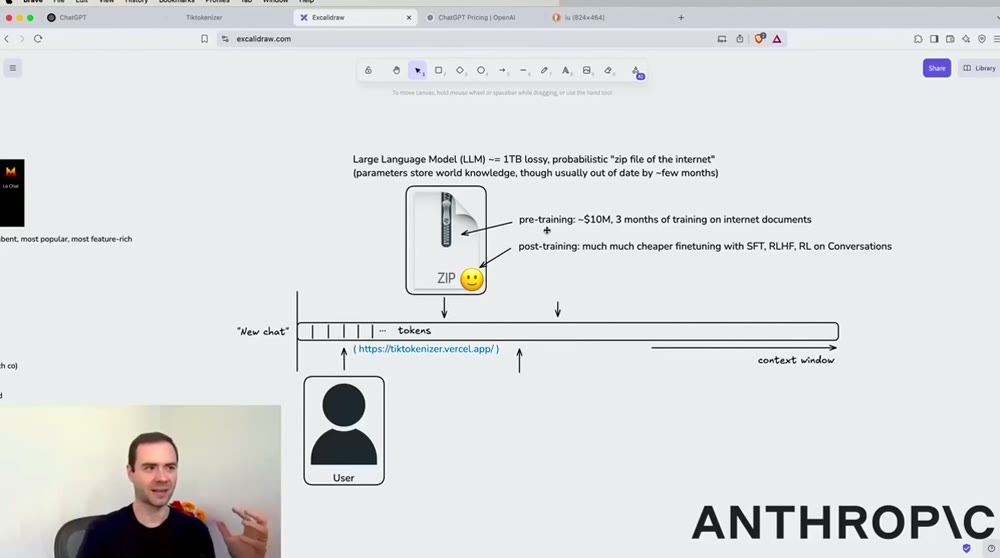
zip file 白板
00:01:20 · 画面上的原始白板:LLM ≈ 1TB lossy, probabilistic “zip file of the internet”,标注 pre-training ~$10M / 3 months of training on internet documents,加 post-training(SFT、RLHF、RL on conversations);下方是 “New chat” 的 token 条,箭头指向 context window,左侧 User 头像往 token 里写字
02 · 钱包

先搞清楚你在跟哪个模型说话

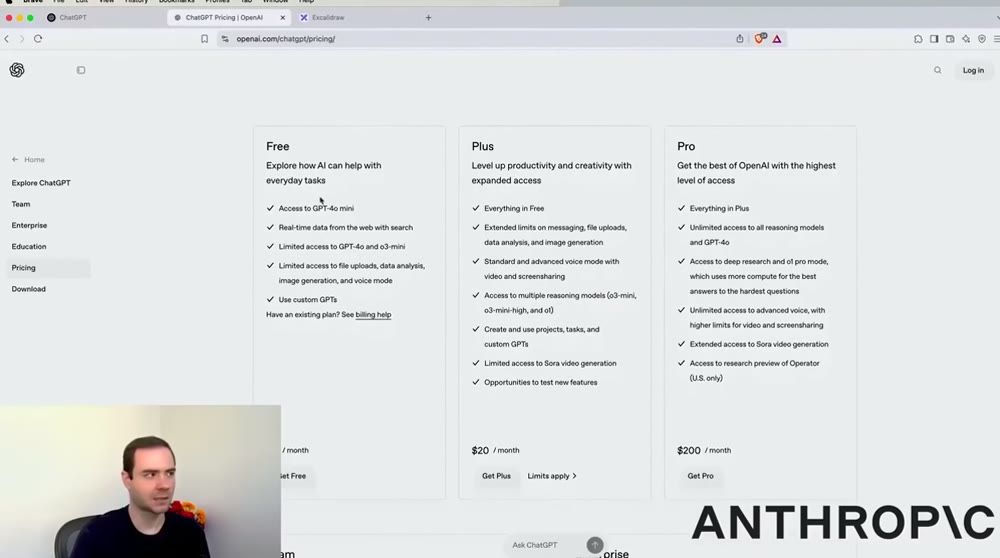
他的第一个实操建议不是提示词,是认清档位:免费站上不登录时,OpenAI 不告诉你用的是哪个模型,很可能是个更小更笨的。他自己的取舍很直白——专业用途就付钱买最强的那档,因为便宜得离谱。

"In my professional work, I do a lot of coding... this is still very cheap for me. So I pay this very gladly."00:13:22
ChatGPT 三档定价
00:11:45 · openai.com/chatgpt/pricing 三栏:Free(GPT-4o mini、限次 4o 与 o3-mini)/ Plus $20/月(扩展消息与上传上限、标准与高级语音、o3-mini / o3-mini-high / o1 的推理模型访问、Sora 限次)/ Pro $200/月(无限 o1 pro mode、deep research、Operator 预览仅美国)
03 · 让他想

thinking 模型:只在「想得出来才算数」的地方开

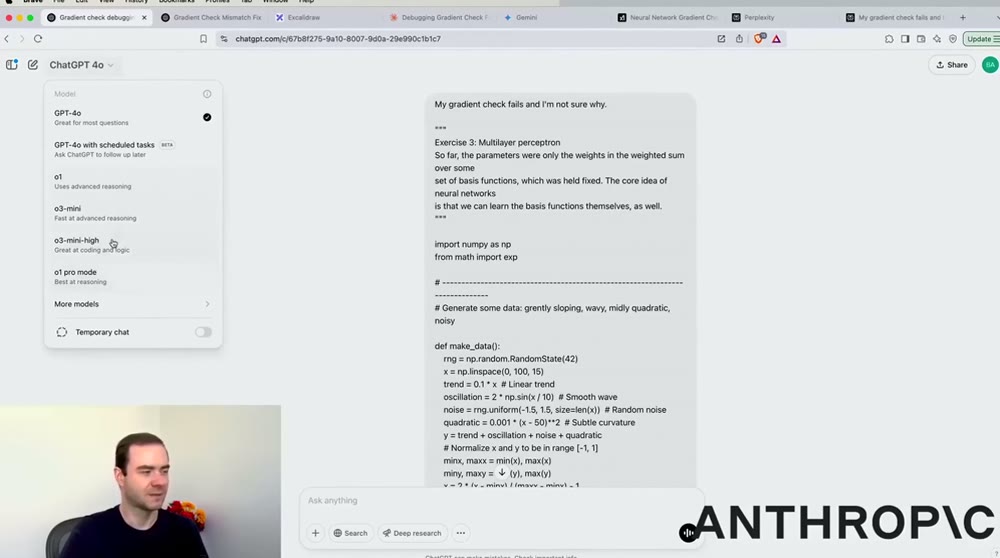
他先拿 GPT-4o 问一个 gradient check 失败的 bug,4o 给了一堆「你可以检查一下」但没解决;换成 o1 pro(思考一分钟)直接指出参数打包/解包不匹配。但同一道题 Claude 3.5 Sonnet 不思考也解对了——所以他的结论不是「一定要开思考」,而是「先试快的,不行再开」。

"I usually try out the non-thinking models because their responses are really fast. But when I suspect the response is not as good as it could have been... I will change it to a thinking model."00:22:38
模型选择器
00:19:40 · 左上角模型下拉:GPT-4o(Great for most questions)、o1(Uses advanced reasoning)、o3-mini(Fast at advanced reasoning)、o3-mini-high(Great at coding and logic)、o1 pro mode(Best at reasoning);右侧是粘进去的多层感知机代码与 “My gradient check fails and I'm not sure why.”
04 · 接网

搜索:给「zip 里没有的新事」开一扇窗

例子是《白莲花度假村》第三季什么时候播。他的判断标准很清楚:信息新鲜 + 互联网上高频 → 可以问模型;不新鲜但高频 → 可以问模型;新鲜且低频 → 必须开搜索。而且不同产品的接线程度不一样,得自己盯着。

"Different models, possibly different apps, have different amount of integration of this capability. So you have to be kind of on the lookout for that."00:30:52
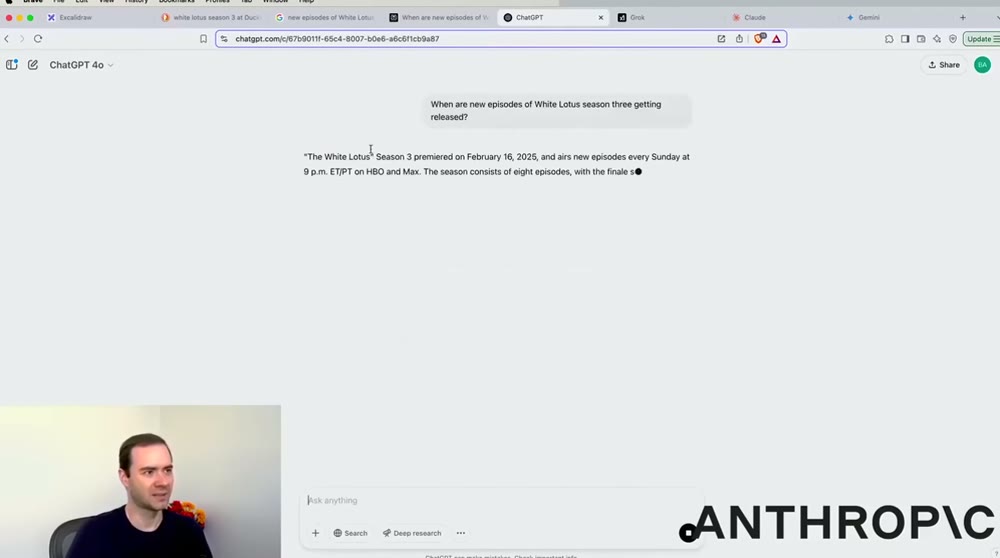
ChatGPT 联网回答
00:28:30 · ChatGPT 未手动点搜索,自己判定要联网:「The White Lotus season 3 premiered on February 16, 2025, and airs new episodes every Sunday at 9 p.m. ET/PT on HBO and Max. The season consists of eight episodes, with the finale s…」
05 · 让它自己查半小时

deep research:思考 + 搜索 + 长时间滚,产出一份带引用的初稿

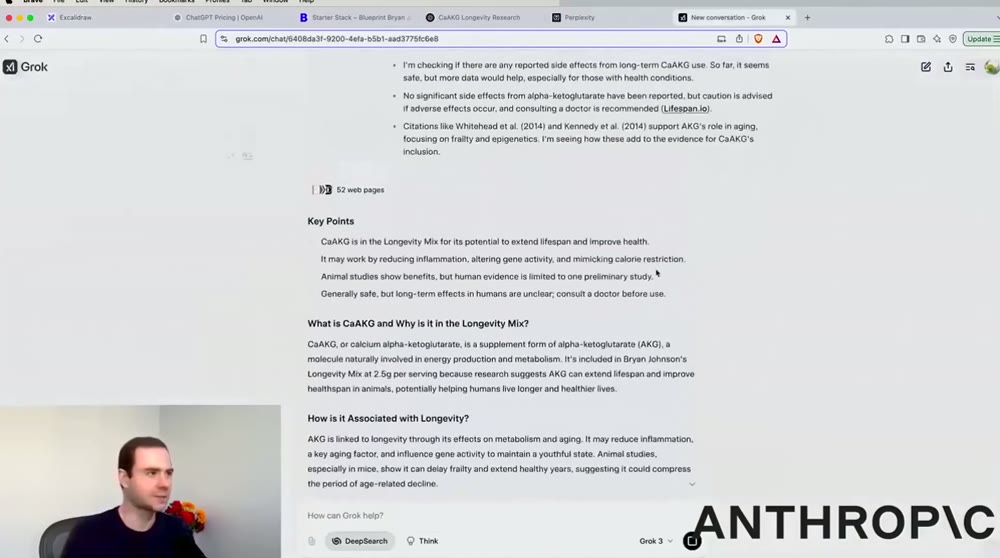
他拿 Bryan Johnson 的 longevity mix 里那个 Ca-AKG 举例子,写了一长串要求(功效、人体/动物证据、机制、毒性)。跑起来要十几分钟,中途可以点开看它在干什么。三家(ChatGPT、Perplexity、Grok)同时跑——Grok 那边显示读了 52 个网页,ChatGPT 自称跑了五分钟、看了 27 个来源。他觉得 ChatGPT 那份最完整,但同时警告:

"There are no guarantees that there are no hallucinations here. Treat this as your first draft. Treat this as papers to look at. But don't take this as definitely true."00:40:37
Grok DeepSearch 关于 Ca-AKG 的报告
00:38:40 · grok.com 的 DeepSearch 输出:页面上标着「52 web pages」,正文分 Key Points / What is CaAKG and Why Is It in the Longevity Mix? / How Is It Associated with Longevity?,并写着 CaAKG 是 α-ketoglutarate 的钙盐、在 Bryan Johnson 的 Longevity Mix 里每份 2.5g
06 · 给它文件

上传:把「它记得」换成「它读得到」

这是他最常用来读书的方式——不是问模型「你记得《国富论》第五章讲什么」,而是把这一章粘进去,让它先总结你正在读的这一章,再逐段问答。他的说法是这让阅读的留存率和理解度大幅上升,而且这个场景至今没有好工具,只能笨拙地复制粘贴。

"It is rarely ever the case anymore that I read books just by myself. I always involve an LLM to help me read a book."00:47:02

同一招用在论文上:30MB 的 Evo 2 论文 PDF 拖进 Claude 直接撞到长度上限("I'm exceeding the length limit of this chat. Oh God."),换 ChatGPT 就正常出摘要。

07 · 让它算

Python 解释器:算不动的时候,它应该去写程序而不是硬猜

他的对照实验很干净:`30 × 9` 心算没问题(本质是记忆不是算);换成大数乘法,ChatGPT 会写一段 Python 跑出结果;Grok 3 没有解释器,心算到一个「非常接近但错误」的答案;Gemini 2.0 Pro 看起来也算对了,但再加难度就错。

"Different LLMs have different tools available to them, and you kind of have to keep track of it. And if they don't have the tools available, they'll just do their best, which means that they might hallucinate a result for you."00:56:03
08 · 让它动手改文件

Artifacts / Cursor:从「给你代码」到「直接把 app 跑在你面前」

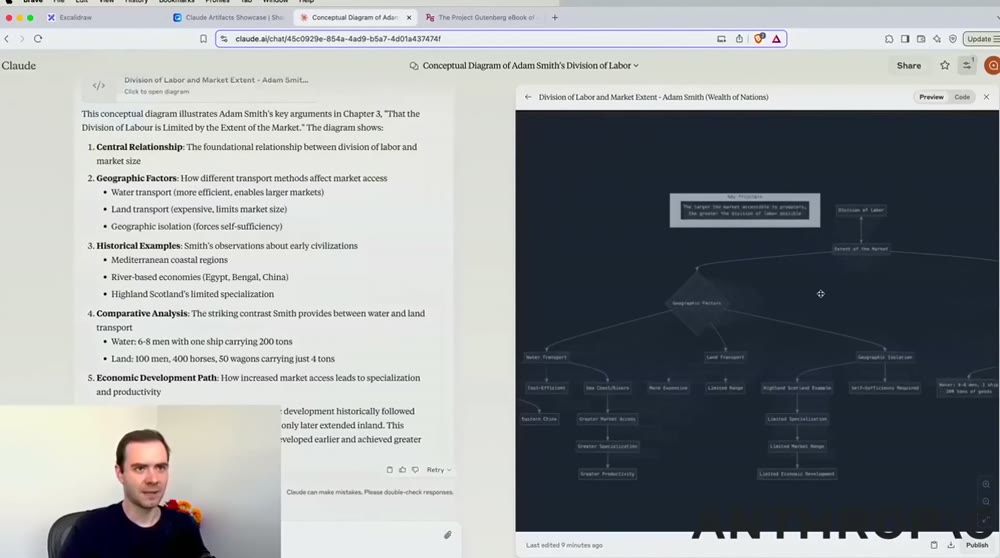
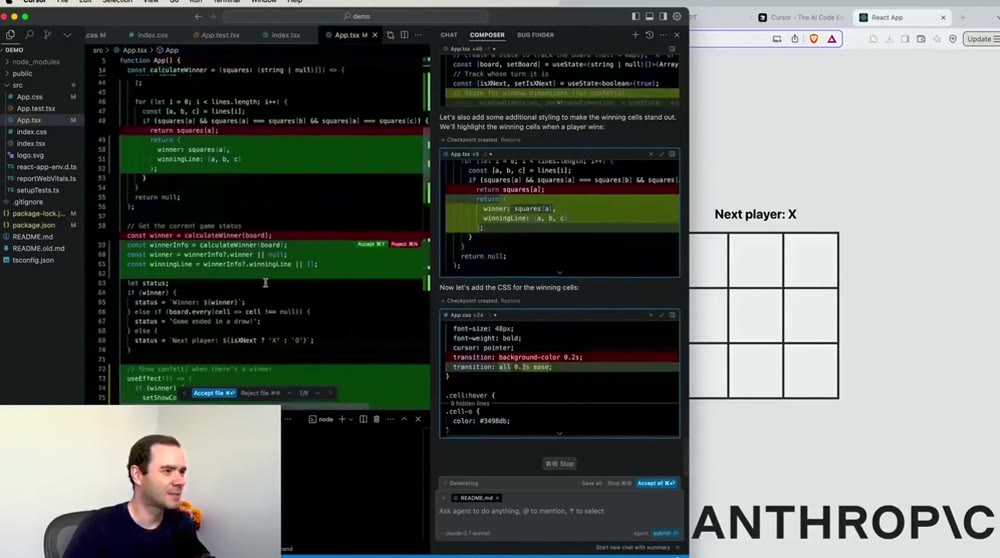
Claude 的 artifacts 把 React 组件直接加载进浏览器——他拿 Adam Smith 的维基介绍生成 20 张抽认卡,再让 Claude 写一个刷卡片的小 app。但他真正的日常不是这个,是 Cursor(底下调 Claude 3.7 Sonnet),用 Composer 从空目录起一个井字棋,然后加 confetti、加音效、加 git commit,一路 vibe coding:

"Vibe Coding just refers to... giving control to Composer and just telling it what to do and hoping that it works."01:09:44
Claude artifact 的概念图
01:04:20 · Claude 侧栏 artifact「Conceptual Diagram of Adam Smith's Division of Labor」,左边是它自己写的五条论点(Central Relationship / Geographic Factors / Historical Examples / Comparative Analysis / Economic Development Path),右边 Preview 里是画出来的关系图,左上角有 Code / Preview 切换
Cursor Composer 改井字棋
01:11:20 · Cursor 里 Composer 正在改 App.tsx:红绿 diff 显示它在改 calculateWinner 相关的行,聊天区写着「Let's also add some additional styling to make the winning cells stand out」,右侧浏览器预览是井字棋,显示 Next player: X
09 · 换嘴和耳朵

语音分两种:假的(转写)和真的(模型内部就是音频)

他先讲「假语音」:桌面端没有麦克风按钮,所以他用系统级的 SuperWhisper,按 F5 说话、再按一次转成文字,说这占了大约一半的提问。然后是「真语音」——Advanced Voice Mode,音频直接变成 token 在模型里进出,没有文本参与。他当场让它扮尤达、扮海盗、数数,并发现它很「端着」:

"I do find that unfortunately the advanced voice is very, very cagey. It really doesn't like to do stuff. It will refuse a lot."01:23:41

顺带拿 Grok 的几种模式做了反差示范(romantic / unhinged / conspiracy / sexy),评价是「OpenAI 很谨慎,Grok 真的会去那儿」。

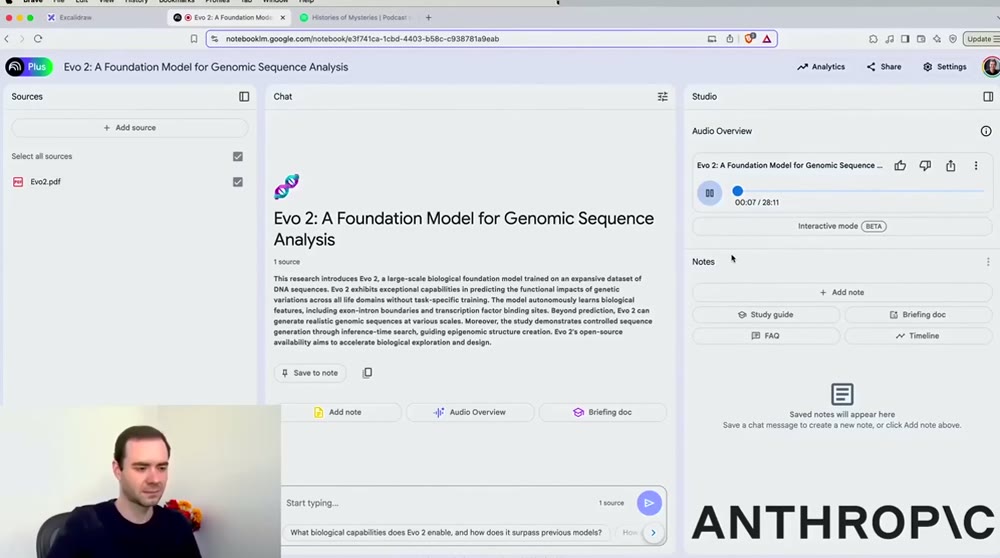
音频这条路他还有第三种玩法:NotebookLM。丢一份 PDF 进去,让它生成一期十几分钟的双人对谈播客,出门散步或长途开车时听。

Advanced Voice 界面
01:21:20 · ChatGPT 高级语音模式的界面:屏幕中央一个蓝色球体,底部只有麦克风和关闭两个圆形按钮,没有输入框
NotebookLM 生成的播客
01:29:30 · notebook.google.com 上的 NotebookLM:Sources 里挂了 Evo2 论文 PDF,中间是它自动生成的摘要,右侧 Studio 的 Audio Overview 正在播(07:28 / 28:11),下面还有 Interactive mode (BETA) 与 Study guide / FAQ / Briefing doc / Timeline
10 · 给它眼睛

图像输入:先让它「转写成文字」,再问问题

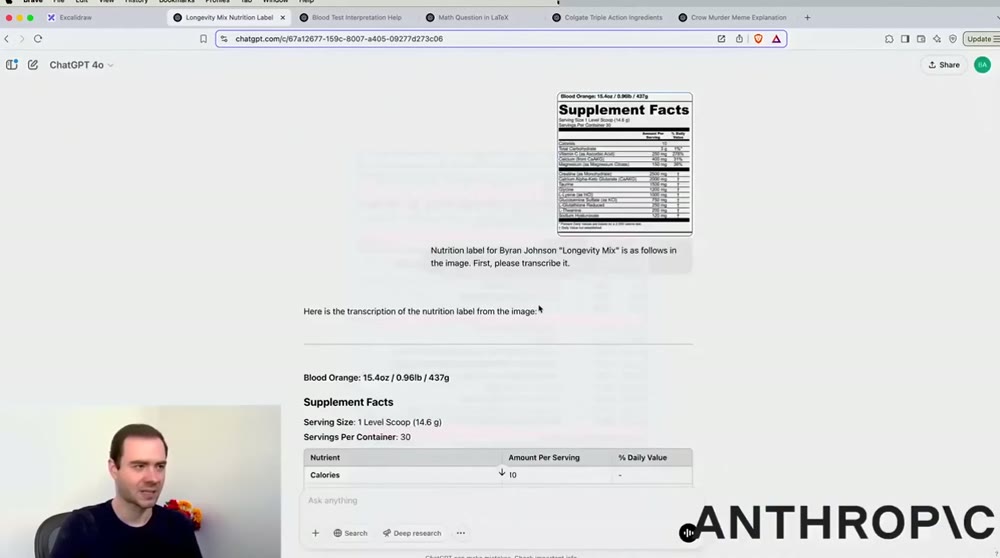
这是他全场最可复用的操作模式。看营养标签、看血检报告、看牙膏成分表、看表情包,一律两步:第一步让它把图里的东西抄成表格(这样你能核对它有没有看错),第二步才对这份文本提问。他的原话是把这一步当成「确认它真的看见了」。

"I like to do it in two steps whenever possible... first I want to transcribe this into text, because I want to make sure that the model is seeing the values correctly."01:33:15
营养标签转写
01:33:10 · ChatGPT 里贴了 Bryan Johnson “Lengevity Mix” 的营养成分表截图,用户消息是「Nutrition label for Bryan Johnson “Lengevity Mix” is as follows in the image. First, please transcribe it.」,下面已经开始按 Supplement Facts 逐项输出表格

图像输出(DALL·E 3)他明确说用得不多,并指出一个机制:现在其实是模型先写一段图片描述,再交给另一个图像模型去画,不是端到端。

11 · 收尾的省事层

记忆、自定义指令、自定义 GPT:把重复的提示词固化下来

记忆是 ChatGPT 独有的(他自己说其他家当时还没有),本质是一个总是被拼到对话最前面的文本库;自定义指令是全局人设(他写的是「别像个 HR,正常说话,能讲原理就讲原理」,还顺便指定了学韩语要用哪种敬语层级)。而自定义 GPT 在他看来一点都不神秘:

"What this feature really is, is that it's just saving you prompting time."01:51:34

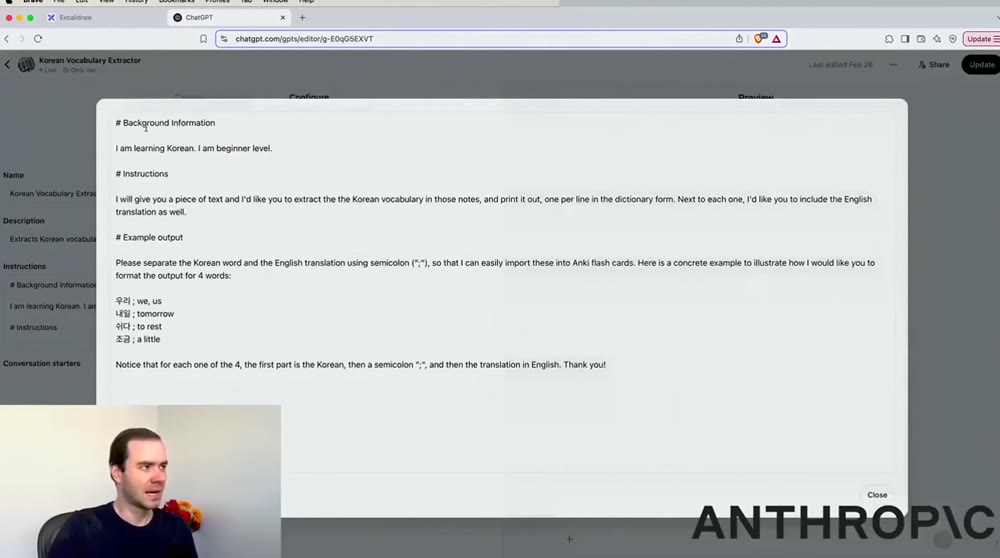
他做的几个全是语言学习:词汇提取器(输出「韩语;英语」一行一个,直接能导进 Anki)、逐词拆解的翻译器、以及一个对截图做 OCR→翻译→拆解的 GPT。方法上他强调一律 few-shot:给描述之外,一定给几个具体例子,必要时用 XML 标签把例子的边界框出来。

自定义 GPT 的指令
01:50:20 · 「Korean Vocabulary Extractor」的 Edit GPT 页面:# Background Information(I am learning Korean, I am beginner level)、# Instructions(抽词、按词典形输出、每行一个、附英文释义)、# Example output(우리; we / 내일; tomorrow / 쉬다; to rest / 조금; a little),并说明要用分号分隔以便导入 Anki
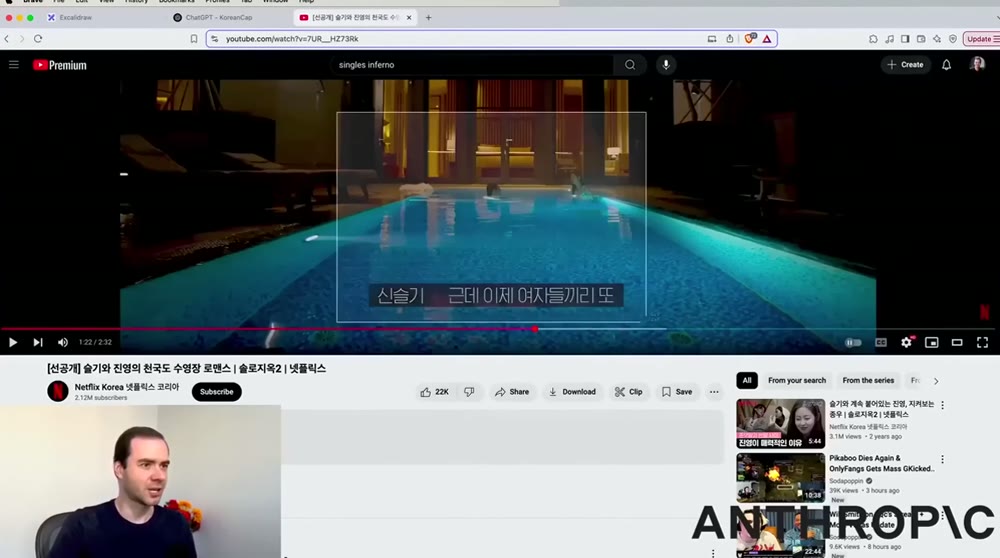
对韩剧截图做 OCR
01:55:20 · YouTube 上《单身即地狱》的画面,他框选了一块压进画面的韩文字幕(“신실기, 근데 이제 아쉽게되기 로”),这块截图会被丢进那个自制的 OCR→翻译→拆解 GPT

能被核对的数字

项值出处 / 语境
zip 文件体积≈1 TB / ≈1 万亿参数白板;1TB 对应约 1012 参数
预训练成本~$10M / 3 个月白板字面;他口头说的是 "many tens of millions of dollars",与板书写法不一致
三档订阅Free / $20 / $200 每月定价页;Plus 给 GPT-4o 80 条/3 小时,Pro 才有 o1 pro 与 deep research
deep research 单次成本十几分钟 + 27 个来源ChatGPT 自称跑了五分钟看 27 个来源;Grok 显示 52 个网页
咖啡因63 mg一份浓缩;他用来演示「知识型问题可以直接问」
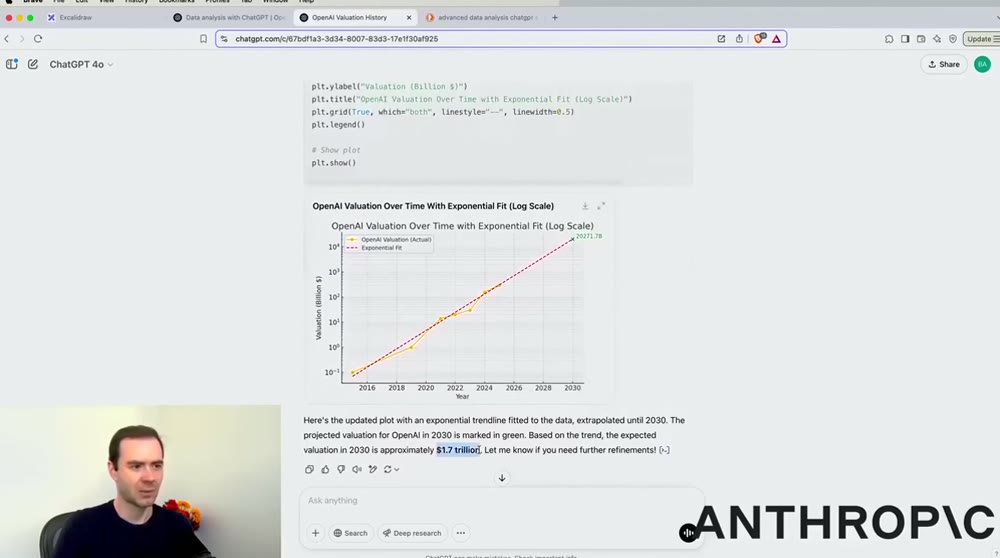
那份估值外推2030 年 1.7 万亿 vs 20 万亿模型嘴上说 1.7T($1.7 trillion),图里标签却是 2027.1B
语言输入比例桌面约 50% / 手机约 80%「因为我懒得打字」

所有数字都能在这份视频的转写里逐字找到;标「白板」的以画面文字为准。

他没明说、但整套流程默认成立的前提

① 上下文窗口是唯一的工作内存

所有「外挂」之所以有用,都是因为能把外部的东西灌进这个窗口:搜索结果、PDF 文本、Python 的返回值、截图 OCR 出来的表。灌不进去的能力,就等于不存在。

② 窗口里的 token 是资源,会花钱也会分心

他反复说:换话题就开新对话。一半因为贵,一半因为「模型可能在很后面采样时被前面这堆 token 干扰」,会降低准确率。

③ 它「算」和它「记」是两件事

`30×9` 是记忆,不是算术;所以必须区分数值任务的两种失败模式:想不起来(该联网)和算不准(该上解释器)。分不清就会在错的地方加外挂。

④ 工具是靠人的示例教出来的

「什么情况下该拿工具、怎么拿」是标注数据集教出来的行为,不是推理出来的。所以换个模型、换个 app,这套行为就没了——Grok 3 心算乘法就是例子。

⑤ 同一个模型,网页版和手机版不是同一个产品

桌面没有麦克风按钮、高级语音与视频只在手机、Operator 只在美国、有些功能只在 Pro 档。他把它总结成一句「这是个动物园」。

⑥ 你自己得能读它写的代码

用 Advanced Data Analysis 画图时他说得很明白:如果你读不了它生成的代码,他不太敢推荐你用这个功能。这条其实是整场对「工具」的态度底线。

哪里会崩

推文的标签和视频内容对不上

推文卖的是「Prompts → Agents → Harness → Loops → Graphs」的 AI 工程五层,视频里没有 harness、loops、graphs 这些章节。这是一份 2025 年 2 月的工具巡览(片内锚点:Claude 3.7 刚发布、Claude 自称 knowledge cutoff 2024 年 4 月)。X 版还比原片短约 4 分半(片头被剪),画面右下角带 ANTHROP\C 角标——二手转载,不是原始发布。

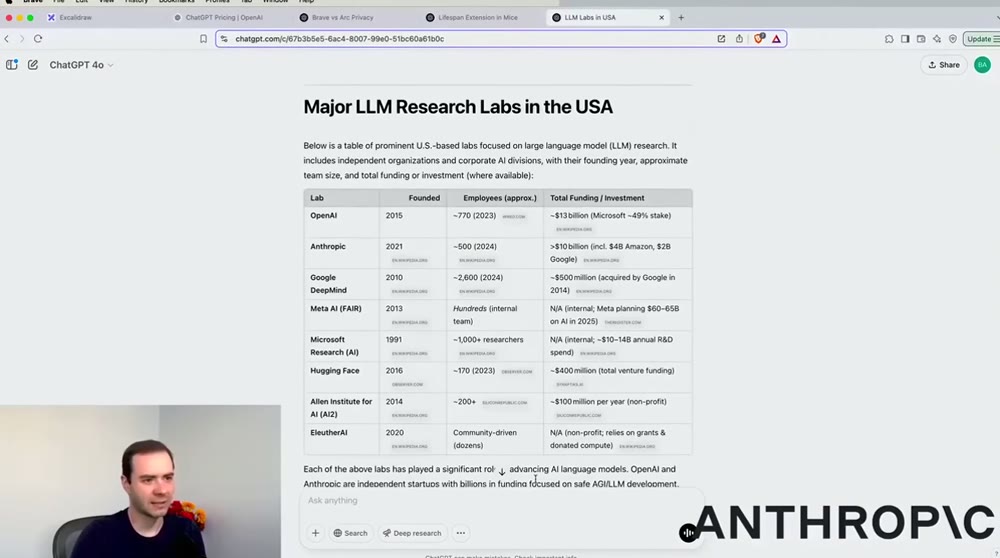
它自己做的表格会漏掉整家公司

他让 ChatGPT 做「美国主要 LLM 实验室」的表,结果 xAI 完全不在表里,Hugging Face 被算进来(但他问的是 LLM 实验室),EleutherAI 也被列成主要实验室。他的评价是 hit and miss:「我不完全信任这些数字」。

LLM 实验室表格
00:42:15 · 它产出的 “Major LLM Research Labs in the USA” 表:OpenAI 2015 / ~770 / ~$13 billion(Microsoft ~49% stake)、Anthropic 2021 / ~500 / >$10 billion、Google DeepMind 2010 / ~2,600 / ~$500 million、Meta AI(FAIR) 2013 / Hundreds / N/A、Microsoft Research 1991、Hugging Face 2016、Allen Institute 2014、EleutherAI 2020——确实没有 xAI 那一行

它会悄悄改数据,也会撒谎报数

画 OpenAI 估值曲线时,表里 2015 年是 NA,代码里却被写成 0.1(即默认假设 100 亿→1 亿的估值),没告诉他;然后口头报「2030 年约 1.7 万亿」,图上标签却是 2027.1B,真实外推是 20 万亿。他去对质,模型回「是啊抱歉我搞错了」。

估值外推图
00:58:40 · “OpenAI Valuation Over Time With Exponential Fit (Log Scale)” 的代码与图同屏:图右端标注 2027.1B,而它下面的文字写着 “the expected valuation in 2030 is approximately $1.7 trillion”

没有工具它会硬猜,而且猜得像真的

Grok 3 没有 Python 解释器,那道大数乘法它给了个「非常接近」的答案;Gemini 2.0 Pro 同理,加大难度就错。这比干脆拒答危险得多——他专门提醒这种错「remarkably close」。
能力分布在产品之间是碎的

同一时期:Claude 3.5 没有联网搜索(答「截至 2024 年 4 月」)、没有 thinking 模型;Gemini 2.0 Pro 没有实时信息(2.0 Flash 反而有);ChatGPT 桌面端没有麦克风按钮;Advanced Voice 只给付费档(他说拍摄当天刚开始向免费用户铺开)。他的结论就是「你得自己盯着」。

他自己的免责声明

血检报告那一节,他先说「这是医疗信息,你不想它出错吧」,然后给出的理由不是准确性,而是「这些数字在互联网上出现得足够多,所以我比较敢信」,最后仍然补一句「你可能还是想去看真正的医生」。整场所有 deep research 的产出都被他定性为初稿和文献索引,不是结论。

把领域删掉,剩下什么

判定

这场的价值不在观点,在校准:他把「模型是个封闭的有损压缩包」这个粗糙但极其好用的比喻,一直推到每个具体产品上,于是每个功能都能被问一句「你补的是它的哪个缺口」。看完你不会更懂 agent 架构,但你会知道什么时候该开新对话、什么时候该开思考、什么时候该骂它撒谎。

代价是它已经过时了一年多:Claude 3.7、o1 pro、Operator、Sora 这些型号和档位全部换过一轮,具体结论要打折;真正还立得住的是那几个操作模式(先转写再问、先快后慢、先信引用再信正文)。推文说「这堂免费课胜过大多数付费 AI 工程课」——就这份内容的密度和自曝错误的诚实程度而言,这句夸张得不算多。